Veröffentlicht am
Ein einzelner Webserver ist einfach, bis er ein Update braucht oder ausfällt. Mit zwei Webservern und einem Load-Balancer davor verteilt sich die Last, und fällt einer aus, übernimmt der andere. Ich kann einen aber auch absichtlich herausnehmen, zum Beispiel um das nächste große Update einzuspielen und selbst zu prüfen, bevor wieder Besucher darauf landen. Die merken davon nichts, solange trägt der andere Server alles.
Hier steht, wie ich das mit HAProxy aufgebaut habe: wer TLS macht, wie die Besucher verteilt
und an einen Server gebunden werden. Als Probe aufs Exempel spiele ich danach ein
Update durch. Das Beispiel sind zwei Webserver web1 und web2, auf web1 soll ein Update.
Alles bezieht sich auf HAProxy 3.0.
Der Aufbau
Das hier ist eine Testumgebung, kein Vorschlag für den produktiven Betrieb. HAProxy und die beiden Webserver laufen als drei Container auf einer Maschine, damit sich alles in einer Minute starten und wieder wegwerfen lässt:
services:
    haproxy:
        image: haproxy:3.0-alpine
        ports:
            - '80:80'
            - '443:443'
        volumes:
            - ./haproxy.cfg:/usr/local/etc/haproxy/haproxy.cfg:ro
            - ./ssl:/etc/haproxy/ssl:ro

    web1:
        image: nginx:alpine

    web2:
        image: nginx:alpine
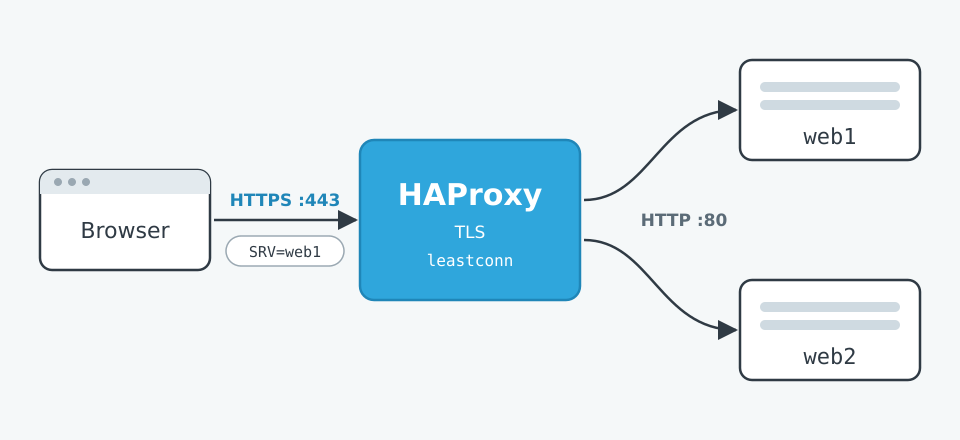
Nur HAProxy hat Ports nach außen. Die beiden Webserver sind nur im Netz von Compose
erreichbar, und dort unter ihrem Dienstnamen: web1 und web2. In ./ssl liegt das
Zertifikat samt Schlüssel in einer Datei, für den Test reicht ein selbst ausgestelltes.
Ausfallsicher ist das nicht. Fällt die Maschine aus, sind beide Webserver weg, und der HAProxy gleich mit. Im Betrieb stehen die Webserver auf getrennten Maschinen mit festen Adressen. Am Ablauf weiter unten ändert das nichts, die Befehle sind dieselben.
Dazu die haproxy.cfg:
global
    # Schnittstelle für Befehle im Betrieb. Hört nur im Container selbst,
    # von außen kommt niemand dran.
    stats socket [email protected]:9999 level admin

defaults
    mode http
    # Ist der Server aus dem Cookie nicht erreichbar, geht die Anfrage an einen anderen.
    option redispatch
    retries 2
    timeout connect 3s
    timeout client 1m
    timeout server 1m
    # Gilt für jede server-Zeile weiter unten:
    #   init-addr last,libc,none  HAProxy startet auch, wenn ein Webserver noch nicht läuft
    #                             und sein Name sich deshalb nicht auflösen lässt
    #   resolvers docker          Namen später über den DNS von Docker nachschlagen
    #   check                     regelmäßig prüfen, ob der Server antwortet
    default-server init-addr last,libc,none resolvers docker check

# Der DNS, den Docker in jedem Container bereitstellt. Er kennt die Dienste aus der
# docker-compose.yml unter ihrem Namen. Startet ein Container neu und bekommt eine
# andere Adresse, merkt HAProxy das nach spätestens 5 Sekunden.
resolvers docker
    nameserver dns 127.0.0.11:53
    hold valid 5s

# Port 80 nimmt nur an, um auf https umzuleiten.
frontend http
    bind :80
    http-request redirect scheme https code 301

# Hier endet TLS. Das Zertifikat liegt nur am HAProxy.
frontend https
    bind :443 ssl crt /etc/haproxy/ssl/example.pem alpn h2,http/1.1
    # Adresse des Besuchers als X-Forwarded-For an den Webserver weitergeben
    option forwardfor
    # dem Webserver sagen, dass der Besucher über https kam
    http-request set-header X-Forwarded-Proto https
    default_backend webservers

backend webservers
    # Neue Besucher gehen an den Server mit den wenigsten offenen Verbindungen.
    balance leastconn
    # Cookie SRV klebt den Besucher an seinen Server. Es verfällt nach 30 Minuten
    # ohne Aufruf, spätestens nach 12 Stunden.
    cookie SRV insert indirect nocache maxidle 30m maxlife 12h
    # Hintertür zum Testen: Cookie SRVTEST=<Servername> führt auf genau diesen Server,
    # auch wenn er gesperrt ist.
    force-persist if { req.cook(SRVTEST) -m found }
    use-server %[req.cook(SRVTEST)] if { req.cook(SRVTEST) -m found }
    # server <Name> <Dienst aus docker-compose.yml>:<Port> cookie <Wert im Cookie SRV>
    # Die Webserver hören nur auf Port 80, ohne TLS.
    server web1 web1:80 cookie web1
    server web2 web2:80 cookie web2
Drei Stellen davon tragen den Update-Ablauf:
stats socketöffnet die Schnittstelle, über die man HAProxy im Betrieb Befehle gibt.cookie SRV insertklebt jeden Besucher an seinen Server. Beim ersten Aufruf setzt HAProxy ein CookieSRV=web1oderSRV=web2, danach landet der Besucher immer wieder dort. Nötig ist das nicht, wenn die Sitzungen an einer gemeinsamen Stelle liegen (siehe unten). Ich mache es, damit alle Anfragen eines Besuchers im Log desselben Servers stehen.force-persistunduse-serversind die Hintertür für mich selbst. Dazu weiter unten.
Die Zeilen default-server ... init-addr ... resolvers docker und der Block resolvers docker
sind Zugeständnisse an die Testumgebung. Container bekommen ihre Adresse erst beim Start, und
nach einem Neustart kann es eine andere sein. Ohne init-addr ... none bricht HAProxy beim
Start ab, sobald einer der Webserver gerade nicht läuft. Ohne resolvers merkt er sich die
Adresse vom Start und schickt nach einem Neustart des Webserver-Containers ins Leere. Mit
beidem startet HAProxy auch ohne web1 und findet ihn von allein wieder, wenn er zurückkommt.
Stehen die Webserver auf eigenen Maschinen mit fester Adresse, fällt das alles weg. Dann
steht dort schlicht server web1 10.0.0.11:80 check cookie web1.
Eine Voraussetzung liegt außerhalb von HAProxy: Die Sitzungen der Besucher müssen an einer gemeinsamen Stelle liegen, zum Beispiel in Redis oder in der Datenbank. Liegen sie auf der Platte des einzelnen Webservers, ist jeder ausgeloggt, den man auf den anderen Server schiebt.
TLS endet am HAProxy
Im Aufbau oben spricht nur HAProxy HTTPS. Das Zertifikat liegt an einer Stelle, in der
bind-Zeile des Frontends. Die Webserver dahinter hören auf Port 80 und wissen von TLS nichts:
server web1 web1:80 cookie web1
Das spart Arbeit bei jedem Update. Ein Webserver ohne Zertifikat, ohne SSL-Modul und ohne 443-VirtualHost hat weniger, was nach einem Update anders sein kann. Läuft das Zertifikat ab, tausche ich eine Datei am HAProxy und nicht eine je Server.
Der Haken: Die Anwendung sieht nur noch HTTP. Fragt sie den Webserver, ob die Anfrage
verschlüsselt war, lautet die Antwort immer nein. Deshalb setzt der HAProxy
http-request set-header X-Forwarded-Proto https. Diesen Header muss die Anwendung an zwei
Stellen auswerten:
- Umleitung auf HTTPS. Leitet der Webserver selbst alles von HTTP auf HTTPS um, entsteht
eine Schleife, denn bei ihm kommt jede Anfrage als HTTP an. Die Umleitung macht hier das
Frontend
httpim HAProxy. Bleibt sie zusätzlich im Webserver, darf sie nur greifen, wennX-Forwarded-Proto: httpsfehlt. - Cookies und Links. Ob das Sitzungs-Cookie das Merkmal
securebekommt und ob erzeugte Links mithttps://beginnen, hängt am selben Header.
Der Verkehr zwischen HAProxy und Webserver ist damit unverschlüsselt. In einem eigenen,
abgeschlossenen Netz ist das üblich. Führt der Weg über fremde Leitungen, gehört auch dort
TLS hin (server web1 web1:443 ssl verify required ca-file ...).
Die IP-Adresse des Besuchers weitergeben
Mit einem Proxy davor kommt beim Webserver jede Anfrage vom HAProxy. Logs, Sperren und Limits
nach IP sehen dann nur noch dessen Adresse. option forwardfor im Frontend schreibt die
Adresse des Besuchers deshalb in den Header X-Forwarded-For.
Die Anwendung muss den Header nicht selbst lesen. Beim Apache erledigt das mod_remoteip:
RemoteIPHeader X-Forwarded-For
# Nur Anfragen aus diesem Netz dürfen die Adresse per Header vorgeben.
# Hier steht das Netz, aus dem der HAProxy kommt.
RemoteIPInternalProxy 172.16.0.0/12
Danach steht in $_SERVER['REMOTE_ADDR'] wieder die Adresse des Besuchers, und der Code
dahinter bleibt, wie er war. Im Access-Log muss dafür %a statt %h im LogFormat stehen,
sonst loggt Apache weiter den HAProxy. Bei nginx heißt das Gegenstück set_real_ip_from und
real_ip_header.
Dem Header darf der Webserver nur trauen, wenn die Anfrage vom HAProxy kommt. Sind die Webserver auch direkt erreichbar, kann sich sonst jeder eine fremde Adresse in den Header schreiben. Am einfachsten nehmen sie auf Port 80 nur Verbindungen vom HAProxy an.
Befehle an HAProxy schicken
Ein eigenes Programm dafür gibt es nicht. Das „CLI“ ist der Socket aus der global-Sektion,
und man schickt Text hinein. Weil er nur im Container hört, gehe ich zuerst dort hinein. nc
ist im Image haproxy:3.0-alpine schon dabei:
docker compose exec haproxy sh
# scur = Verbindungen, die gerade offen sind, status = Zustand des Servers
echo "show stat" | nc 127.0.0.1 9999 | cut -d, -f1,2,5,18,19
# Listet alle Befehle:
echo "help" | nc 127.0.0.1 9999
# pxname,svname,scur,status,weight
https,FRONTEND,1,OPEN,
webservers,web1,0,UP,1
webservers,web2,0,UP,1
webservers,BACKEND,0,UP,2
Alle weiteren Befehle in diesem Beitrag laufen in dieser Shell.
Der Socket hört hier nur auf 127.0.0.1, und das sollte so bleiben. Wer ihn erreicht, kann
Server abschalten. Üblich ist auch ein Unix-Socket (stats socket /run/haproxy/admin.sock),
den man mit socat anspricht. Den habe ich in diesem Aufbau nicht benutzt.
Ein Update ohne Ausfall
Der Aufbau steht. Jetzt soll web1 ein Update bekommen, während web2 alle Besucher trägt.
Schritt 1: Den Server leer machen
Es gibt zwei Zustände dafür, und der Unterschied ist wichtig.
# drain: keine neuen Besucher mehr. Wer schon das Cookie SRV=web1 hat, bleibt auf web1.
echo "set server webservers/web1 state drain" | nc 127.0.0.1 9999
Genau darüber bin ich gestolpert. Ich hatte den Server auf drain gestellt, die Seite neu
geladen und war immer noch auf web1. Kein Fehler, mein Browser hatte das Cookie.
# maint: niemand mehr, auch nicht mit Cookie. Wegen option redispatch landen diese
# Besucher auf web2 und bekommen dort ein neues Cookie.
echo "set server webservers/web1 state maint" | nc 127.0.0.1 9999
| Zustand | Neue Besucher | Besucher mit Cookie für diesen Server |
|---|---|---|
ready |
ja | ja |
drain |
nein | ja |
maint |
nein | nein, sie wandern auf den anderen |
Für ein Update nehme ich direkt maint. drain lohnt sich, wenn die Sitzungen am einzelnen
Server hängen und man die Leute dort in Ruhe auslaufen lassen will. Mit gemeinsamen Sitzungen
gibt es dafür keinen Grund.
Anfragen, die gerade laufen, bricht maint nicht ab. Sie laufen zu Ende, nur neue kommen
nicht mehr an. Vor dem Update warte ich deshalb, bis scur bei web1 auf 0 steht:
webservers,web1,0,MAINT,1
webservers,web2,3,UP,1
Bei beiden Befehlen antwortet HAProxy nur mit einer Leerzeile. Keine Ausgabe heißt, es hat geklappt.
Schritt 2: Das Update
Jetzt gehört web1 mir. Paket einspielen, Dienst neu starten, was auch immer ansteht. Von
außen kommt nichts mehr an.
Schritt 3: Selbst testen, bevor alle wieder draufkommen
Der Server ist aktualisiert, aber ob er läuft, weiß ich noch nicht. Stelle ich ihn jetzt auf
ready, finden es die Besucher für mich heraus. Ich will vorher selbst drauf, als Einziger.
Dafür sind die beiden Zeilen im Backend da:
# Gilt auch, wenn der Server gerade auf maint steht.
force-persist if { req.cook(SRVTEST) -m found }
# Schickt die Anfrage auf den Server, dessen Name im Cookie SRVTEST steht.
use-server %[req.cook(SRVTEST)] if { req.cook(SRVTEST) -m found }
Zusammen ergibt das ein Cookie, mit dem ich mir den Server aussuche, egal in welchem Zustand er ist.
In der Konsole des Browsers:
document.cookie = 'SRVTEST=web1; path=/; secure';
location.reload();
So verhält es sich, solange web1 auf maint steht:
| Cookie | Landet auf |
|---|---|
| keins | web2 |
SRV=web1 |
web2 |
SRVTEST=web1 |
web1 |
SRV=web2 und SRVTEST=web1 |
web1 |
SRVTEST=gibtsnicht |
web2 |
Der Wert des Cookies ist der Servername aus der Konfiguration. Deshalb braucht ein dritter
Server keine eigene Regel, SRVTEST=web3 geht dann von allein. Ein Name, den es nicht gibt,
wird ignoriert, und die Anfrage wird normal verteilt.
Wenn ich fertig bin, lösche ich das Cookie wieder:
document.cookie = 'SRVTEST=; path=/; max-age=0';
location.reload();
Auf einem Server, der im Internet hängt, ist ein Cookie namens SRVTEST zu leicht zu erraten.
Wer es setzt, kommt auf einen Server mitten im Update. Entweder bekommt das Cookie einen Namen,
den niemand rät, oder die Regel gilt zusätzlich nur für interne Adressen, etwa mit
{ src 10.0.0.0/8 } als zweiter Bedingung.
Schritt 4: Wieder freischalten
echo "set server webservers/web1 state ready" | nc 127.0.0.1 9999
Danach passiert weniger, als man denkt. Alle Besucher haben inzwischen ein Cookie für web2
und bleiben dort. Auf web1 landen nur neue Besucher und solche, deren Cookie abgelaufen ist.
Der Server füllt sich also von allein nach und nach.
Und wenn das Update doch kaputt ist:
echo "set server webservers/web1 state maint" | nc 127.0.0.1 9999
Damit sind sofort alle wieder auf web2. Das ist derselbe Befehl wie in Schritt 1, und genau
das macht den Ablauf so angenehm: Es gibt nur einen Schalter, und er geht in beide Richtungen.
Warum leastconn?
balance legt fest, wie HAProxy einen Besucher ohne Cookie verteilt. Hier steht leastconn:
Die Anfrage geht an den Server, der gerade die wenigsten offenen Verbindungen hat.
Der Grund ist der Moment, in dem ein Server zurückkommt. Er hat null Verbindungen, der andere
trägt alles. Mit leastconn bekommt der leere Server die neuen Verbindungen, bis beide wieder
ungefähr gleich viel zu tun haben. roundrobin würde stur abwechseln. Der Server, der die
ganze Zeit allein war, bliebe voll, und der neue bekäme nur die Hälfte von dem, was neu
dazukommt.
Zwei Einschränkungen dazu:
leastconnzählt Verbindungen, nicht Besucher. Wer ein Cookie hat, bleibt, wo er ist. Das Auffüllen betrifft nur die, die neu verteilt werden.- Ein Server, der gerade erst gestartet ist, bekommt den Schwung auf einmal. Dagegen gibt es
slowstart 30san derserver-Zeile, das die Last über die angegebene Zeit hochfährt.
Der Preis: Mit leastconn kann ich nicht verlässlich sagen „dieser Server bekommt 10 %“.
Gewichte lassen sich zwar setzen (set server webservers/web1 weight 10), sie wirken aber nur,
wenn viele Verbindungen gleichzeitig offen sind. Ohne Last hat leastconn bei mir trotz
unterschiedlicher Gewichte einfach abwechselnd verteilt. Wer ein Update erst an einem kleinen
Teil der Besucher ausprobieren will, braucht roundrobin, das hält die Gewichte genau ein.
Mir fehlt das nicht. Vorab testen kann ich mit dem Cookie, und nach dem Freischalten kommen die Besucher ohnehin nur nach und nach.
Was es sonst noch gibt
Kurz, was an der Stelle von leastconn stehen kann:
| Einstellung | Wie verteilt wird | Wofür |
|---|---|---|
roundrobin |
Reihum, nach Gewicht. Gewichte lassen sich im Betrieb ändern | Kurze, gleichartige Anfragen, Verteilung in Prozent |
static-rr |
Wie roundrobin, aber Gewichte gelten erst nach einem Neustart |
Selten nötig, etwas weniger Rechenaufwand |
leastconn |
An den Server mit den wenigsten offenen Verbindungen | Lange oder ungleich lange Anfragen |
first |
Immer der erste Server, bis sein maxconn voll ist, dann der nächste |
Server bei wenig Last abschalten können |
source |
Nach der IP des Besuchers, dieselbe IP landet auf demselben Server | Bindung an einen Server ohne Cookie |
uri |
Nach der aufgerufenen Adresse, dieselbe Adresse immer auf denselben Server | Caches hinter dem Load-Balancer |
hdr(name) |
Nach dem Wert eines Headers | Verteilung nach Kunde oder Mandant |
random |
Zufällig, nach Gewicht | Viele Server, die oft dazukommen und wegfallen |
Solange ein Cookie die Besucher festhält, entscheidet die Einstellung ohnehin nur beim ersten Aufruf.
Worauf du achten musst
Ein Neustart vergisst alles. Was über den Socket gesetzt wurde, steht nicht in der
Konfiguration. Nach einem Neustart von HAProxy ist ein Server auf maint wieder ready. Mir
ist das passiert, als ich während des Tests eine Zeile in der Konfiguration geändert habe.
Wer das mitten im Update tut, schaltet den halbfertigen Server für alle frei. HAProxy kann die
Zustände in eine Datei sichern und beim Start wieder laden (server-state-file).
drain ist nicht leer. Wer nur drain setzt und dann das Update einspielt, trifft alle,
die noch ein Cookie für diesen Server haben.
Das eigene Cookie führt in die Irre. Solange SRVTEST gesetzt ist, sehe ich immer den
einen Server, egal was ich am Socket umstelle. Nach dem Test also löschen, sonst prüft man
stundenlang etwas anderes als die Besucher sehen.
Der Servername ist nicht der Hostname. In den Befehlen steht webservers/web1, also
Backend und der Name aus der server-Zeile. Nicht die Adresse und nicht der Name der Maschine.
Was mit zwei Servern sonst noch kommt
Der Load-Balancer ist der kleinere Teil. Sobald dieselbe Anwendung zweimal läuft, tauchen ein paar Fragen auf, die HAProxy nicht beantwortet:
- Cronjobs. Läuft derselbe Job auf beiden Servern, läuft er doppelt. Läuft er nur auf einem, steht er still, solange dieser Server im Update ist.
- Datenbank-Migrationen. Während des Updates arbeiten alter und neuer Code gegen dieselbe Datenbank. Eine Schemaänderung muss mit beiden Versionen funktionieren.
- Dateien. Ein Upload landet auf einem Server, die nächste Anfrage auf dem anderen. Hochgeladenes gehört auf gemeinsamen Speicher, genauso wie die Sitzungen.
- Reserve. Während des Updates trägt ein Server alles. Reicht er nur für die Hälfte, erzeugt das Update selbst den Ausfall.
- Der HAProxy selbst. Er ist jetzt die eine Stelle, an der alles hängt. Üblich sind zwei davon mit einer gemeinsamen Adresse, die bei einem Ausfall wandert.
Der Ablauf in vier Zeilen
set server webservers/web1 state maint, warten bisscurauf 0 steht.- Update auf
web1einspielen. - Mit
SRVTEST=web1selbst prüfen, Cookie wieder löschen. set server webservers/web1 state ready. Geht etwas schief, zurück zu Schritt 1.